openFuyao技术讲堂 | AI推理KVCache索引管理

 2026-09-30
特性介绍
大语言模型推理服务中,KVCache是提升推理性能的关键。然而当多个推理实例同时服务时,请求路由往往无法感知各实例的缓存状态,导致原本可以命中缓存的请求被调度到“冷”实例上,缓存命中率大打折扣。 openFuyao社区推出cache-indexer为AI推理场景带来了全局KVCache索引能力---它统一维护L1(推理实例本地高带宽显存HBM,来自推理引擎vLLM。)与L3(推理实例内存缓存,来自分布式缓存系统Mooncake。)两层KVCache视图。路由组件可调用cache-indexer查询候选推理实例的KVCache命中率,从而进行更准确的请求级调度。
应用场景
cache-indexer适用于在Kubernetes集群中部署大语言模型推理服务,并需要基于KVCache命中情况优化请求路由的场景。
- 多实例推理后端:多个vLLM(推理引擎)实例同时提供服务,需要根据请求前缀缓存命中情况选择更合适的实例。
- KVCache感知路由:Hermes-router等路由组件需要获取L1/L3命中率,用于KVCache aware类路由策略。
- 分布式缓存复用:推理服务使用Mooncake等分布式缓存管理系统,希望将已下沉到内存的KVCache纳入调度依据。
- 动态扩缩容场景:推理实例或Mooncake Master发生上下线时,需要cache-indexer自动发现并更新索引采集目标。
实现原理
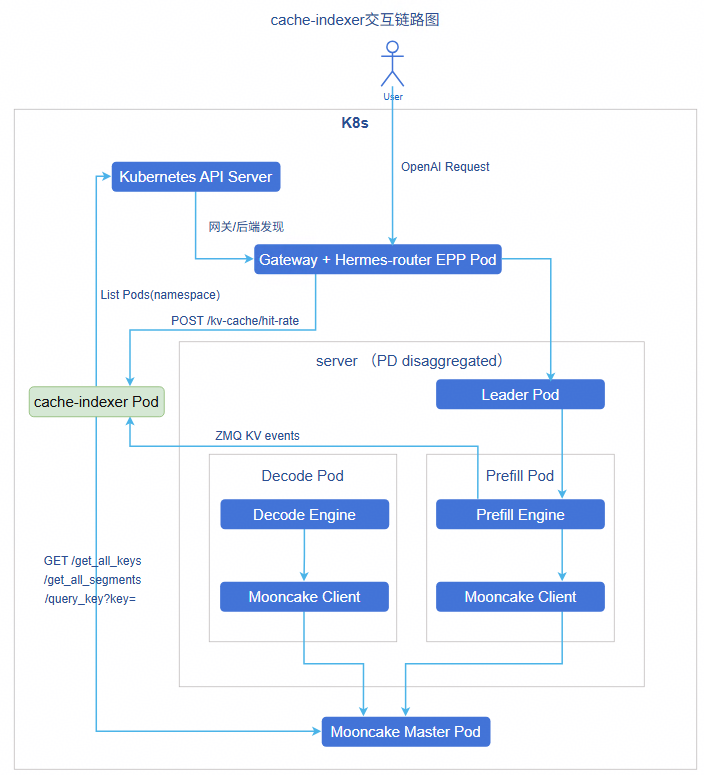
cache-indexer位于路由决策路径上,主链路如下。
- cache-indexer通过Kubernetes API Server列举带特定label的vLLM Pod与Mooncake Master Pod,构造发现快照。
- 对每个vLLM Pod启动一路ZMQ SUB(ZeroMQ Subscriber,基于ZeroMQ消息队列的订阅者。这里指cache-indexer订阅vLLM事件的接收端。),订阅
BlockStored/BlockRemoved/AllBlocksCleared事件,写入L1索引。 - 对Mooncake Master周期调用
GET /get_all_keys和GET /query_key,拉取block副本列表,并通过GET /get_all_segments解析vLLM Pod IP地址到Mooncake client传输端点的映射,写入L3索引。 - 路由组件调用
POST /kv-cache/hit-rate,cache-indexer在L1/L3两张索引上分别计算最长连续前缀命中并返回。
图1 cache-indexer交互链路图
安装部署及使用
cache-indexer支持独立部署和InferNex集成部署两种方式。详细安装步骤请参见安装。
推理引擎(vLLM)和分布式缓存管理系统(Mooncake)的联动配置参数说明请参见推理引擎配置及Mooncake配置。
未来展望
openFuyao社区将在以下方向持续演进KVCache索引管理能力:
- 多KV组模型分组块哈希对齐:社区将补齐hybrid多KV组模型的分组块哈希对齐能力,确保混合架构模型在L1/L3索引上的命中率计算准确可靠。
- 多DP(Data Parallelism,数据并行,多卡/多实例间各自独立持有模型副本与KVCache 的并行模式。) rank粒度KV-event采集:当前L1索引订阅以推理实例为粒度,社区将扩展支持多DP rank粒度的KV-event订阅采集,让同一实例内多个并行rank的KVCache状态可独立追踪与查询。
- 推理引擎与缓存组件生态扩展:社区将扩展对更多推理引擎和KVCache分布式缓存管理组件的适配,降低用户选型约束,提升生态适配能力。
资源参考
openFuyao v26.06版本软件包下载地址:https://www.openFuyao.cn/zh/download/
本文由openFuyao社区首发,欢迎遵照CC-BY-SA 4.0协议规定转载。